Ką moka už 4,5 mln. eurų sukurti „melagienų“ DI modeliai: mūsų testas
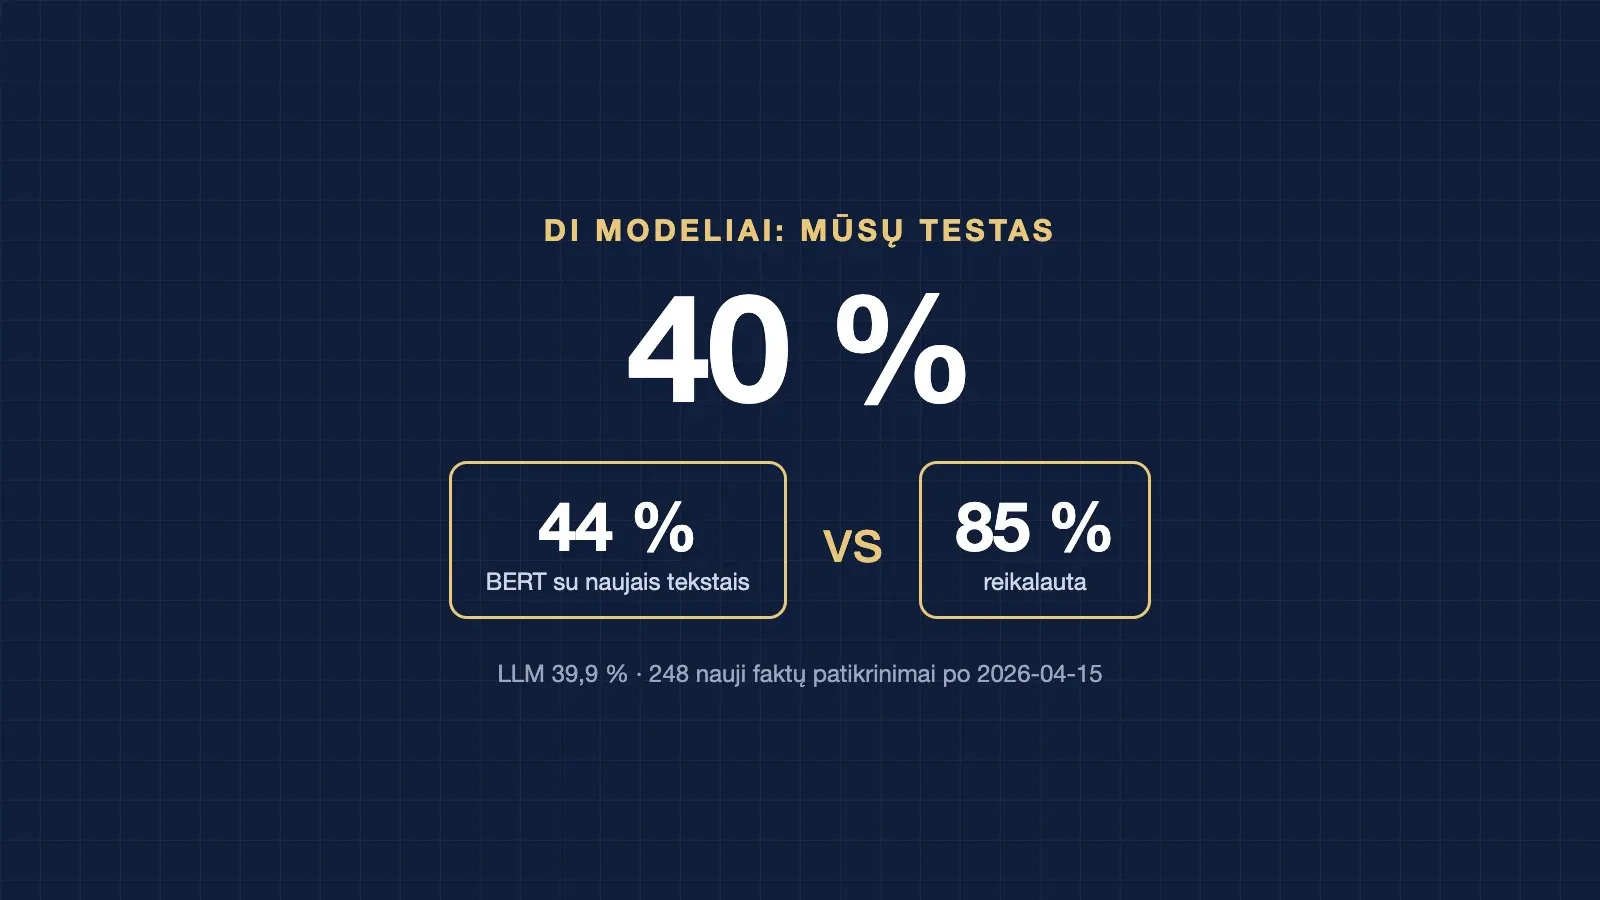
- Specifikacija reikalavo, kad DI sprendimai atpažintų klaidinančią informaciją ne mažesniu kaip 85 % tikslumu; BERT kortelė skelbia 89,52 %, LLM – 68 %.
- Su visu tekstynu BERT pasiekia 93,06 %, bet tai viršutinė riba: modelis mokytas ant to paties tekstyno, o 99 % „Teisinga“ įrašų turi antraštę – modelis gali mokytis žanro.
- Su 248 faktų patikrinimais, paskelbtais po 2026-04-15, tikslumas 43,95 % (makro F1 0,387): „Melo detektorius“ 43,0 %, 15min 35,6 %.
- 56 iš 234 paneigtų teiginių modelis pažymėjo „Teisinga“, tarp jų – klastotę apie V. Zelenskį ir teiginį, kad skiepai nuo gripo neveiksmingi.
- LLM su tais pačiais 248 naujais faktų patikrinimais pasiekė tik 39,9 % (su tekstyno įrašais – 62,7 %); 66 iš 234 paneigtų teiginių jis pažymėjo „Teisinga“, pvz., „Saulė nesukelia vėžio“ – „kas yra tiesa“.
- Kortelių neatitikimai: testas 6 043 eilutės > 5 162 įrašai, LoRA r 32/16, LLM epochų 66 % ir 68 %.
- Viskas atkuriama: modelio commit b4ce894…, failų sha256, paketų versijos ir šeši skriptai (keturi BERT, du LLM).
Ši dalis – 77.lt DI redakcijos tyrimo „Melagienų tekstynas už 4,5 mln. eurų“ dalis. Duomenis išnagrinėjo DI agentai, skaičiavimai pakartojami skriptais, teiginius nepriklausomai patikrino kitas DI agentas.
Už 4,5 mln. eurų sukurto projekto rezultatas – ne tik tekstynas, bet ir du DI modeliai, kurie turėtų atpažinti klaidinančią informaciją. Techninė specifikacija reikalavo pademonstruoti, kad DI sprendimai tai daro ne mažesniu kaip 85 % tikslumu (konkretaus modelio nenurodė). BERT modeliui kūrėjai skelbia 89,52 %. Šį modelį patikrinome dviem būdais: su pačiu tekstynu ir su 248 naujais faktų patikrinimais, paskelbtais jau po modelio mokymo. Su naujais tekstais modelio tikslumas – 43,95 %. Pagrindinis tyrimas – čia.
Su 248 faktų patikrinimais, paskelbtais po 2026-04-15, BERT modelio tikslumas 43,95 %, makro F1 0,387; atsitiktinio spėjimo lygis trims klasėms – 33 %. Iš 234 faktų tikrintojų paneigtų teiginių modelis 56 (24 %) pažymėjo „Teisinga“. Su tekstynu, ant kurio buvo mokytas, tas pats modelis pasiekia 93,06 %.
Kas paskelbta
| Rezultatas | Paskelbta | Atsisiuntimai (30 d. / iš viso) | „Patinka“ |
|---|---|---|---|
| BERT klasifikatorius (160 mln. parametrų, kito VSSA projekto modelio pagrindu) | 2026-03-25 | 33 / 147 | 0 |
| LLM – LoRA priedas „Google Gemma 3 12B“ modeliui | 2026-04-01 | 30 / 99 | 0 |
| Tekstynas (Hugging Face) | 2026-04-01 | 61 / – | 0 |
| Tekstynas (data.gov.lt, būsena „Juodraštis“) | 2026-04-14 | 84 peržiūros | 0 |
Duomenys – Hugging Face ir data.gov.lt puslapiai, tikrinta 2026-10-10.
1 testas. BERT su visu tekstynu: 93,06 % – viršutinė riba
Paleidome modelį su visais 5 162 tekstyno įrašais, naudodami tą pačią įvestį, kurią kortelė nurodo testui (visas tekstas, iki 4 096 žetonų). Tikslumas – 93,06 %, makro F1 – 0,931. Tai ne modelio tikslumas su naujais tekstais: modelis mokytas ant šio paties tekstyno (pagal kortelę – 80 % įrašų, kiekvienas trimis pavidalais), todėl rezultatas rodo, kiek jis „prisimena“ mokymo duomenis.
| Tekstyno žyma | Modelis: Klaidinga | Manipuliatyvu | Teisinga |
|---|---|---|---|
| Klaidinga (1 813) | 1 743 | 64 | 6 |
| Manipuliatyvu (1 675) | 255 | 1 411 | 9 |
| Teisinga (1 674) | 11 | 13 | 1 650 |
Žanras, ne turinys. Įrašų su antrašte tikslumas – 97,3 %, be antraštės – 89,8 %. Iš 1 674 „Teisinga“ įrašų net 1 658 (99 %) turi antraštę, t. y. tai naujienų straipsniai, o „Klaidinga“ ir „Manipuliatyvu“ daugiausia yra socialinių tinklų įrašai be antraštės (žr. 2 dalį). Todėl modelis gali išmokti skirti teksto žanrą („straipsnis“ prieš „įrašą“), o ne teiginio teisingumą.
2 testas. BERT su 248 naujais tekstais: 43,95 %
Modelis apmokytas 2026-04-02. Surinkome faktų patikrinimus, paskelbtus po 2026-04-15, taigi modelis jų negalėjo matyti:
| Šaltinis | Klaidinga | Manipuliatyvu | Teisinga |
|---|---|---|---|
| Delfi „Melo detektorius“ (skiltis „Teiginiai“) | 113 | 80 | – |
| 15min „Patikrinta“ (pirma citata kabutėse) | 15 | 26 | 4 |
| Valstybės duomenų agentūros oficialioji statistika | – | – | 10 |
Žymų priskyrimas (skriptas build_oos_set.py): „Melas“, „Klastotė“ → Klaidinga; „Manipuliacija“, „Iš dalies melas“, „Iš dalies tiesa“, „Trūksta konteksto“, „Klaidinantis turinys“ → Manipuliatyvu; 15min „tiesa“ ir oficialioji statistika → Teisinga. Mišrūs verdiktai atmesti (7 Delfi ir 3 15min straipsniai). Tik 3 tekstai su tekstynu persidengia 0,8 ar daugiau (pagal 5 simbolių sekas); be jų tikslumas 44,5 %.
| Imtis | Tekstų | Tikslumas |
|---|---|---|
| Visi | 248 | 43,95 % (makro F1 0,387) |
| Delfi „Melo detektorius“ | 193 | 43,0 % |
| 15min „Patikrinta“ | 45 | 35,6 % |
| Tik paneigti teiginiai (Klaidinga ir Manipuliatyvu) | 234 | 42,3 % |
| Oficialioji statistika | 10 | 10 iš 10 „Teisinga“ |
| Paskelbtas verdiktas | Modelis: Klaidinga | Manipuliatyvu | Teisinga |
|---|---|---|---|
| Klaidinga (128) | 70 | 32 | 26 |
| Manipuliatyvu (106) | 47 | 29 | 30 |
| Teisinga (14) | 3 | 1 | 10 |
„Manipuliatyvu“ klasės atkūrimas – vos 0,274: modelis atpažįsta tik kas ketvirtą manipuliatyvų teiginį. 56 iš 234 paneigtų teiginių pažymėti „Teisinga“, dažnai su tikimybe apie 1,00. Pavyzdžiai:
- „Skiepai nuo gripo yra neveiksmingi, patys skatina viruso plitimą…“ (Delfi: Melas) – modelis: Teisinga;
- dirbtiniu intelektu sukurta klastotė apie ukrainiečių kalbą kaip antrąją valstybinę (Delfi: Klastotė) – Teisinga;
- „Vaizdo įraše užfiksuota, kaip … V. Zelenskis vartoja narkotikus“ (Delfi: Klastotė) – Teisinga.
Kontrolės
- Teksto ilgis kritimo nepaaiškina. Naujų tekstų ilgio mediana – 106 simboliai. Tekstyne trumpus (iki 400 simbolių) „Klaidinga“ ir „Manipuliatyvu“ tekstus (1 202 įrašai) modelis atpažįsta 90,6 % tikslumu, ir tik 2 iš jų pažymi „Teisinga“.
- Stilius. Visi 10 oficialiosios statistikos sakinių pažymėti „Teisinga“, o visi 4 15min „tiesa“ verdiktai (socialinių tinklų įrašų citatos) – ne „Teisinga“. Tai dera su žanro hipoteze: oficialus naujienų stilius modeliui reiškia „Teisinga“.
Mūsų vertinimas. 93 % su mokymo tekstynu ir 44 % su naujais tekstais – būdingas persimokymo arba žanro išmokimo požymis. Kuriuo testu buvo pripažinta, kad pasiektas 85 % reikalavimas, turi atsakyti užsakovas.
Kortelių neatitikimai
- Testas didesnis už visumą. BERT kortelėje: validavimas 5 437, testas 6 043 eilutės, o visame tekstyne – 5 162 įrašai. Kortelėje rašoma, kad įrašai išplėsti trimis pavidalais (7-Statement, 8-Statement_Context, 9-Full_text) ir tik tada atsitiktinai padalyti (80/10/10, sėkla 42). Jei taip, to paties įrašo variantai pateko ir į mokymą, ir į testą, todėl 89,52 % nėra švarus testas.
- Paskelbta ne tai, kuo mokyta. Stulpelių 7-Statement, 8-Statement_Context ir fakto tikrintojų pagrindimų viešame tekstyne nėra, todėl kortelės testo atkartoti negalima.
- LoRA parametrai. LLM kortelėje nurodyta r = 32, alpha = 64, o paskelbtame adapterio faile – r = 16, alpha = 16.
- LLM epochos. Kortelėje rašoma, kad geriausia – 1 epocha, o testo tikslumas 68,0 %. Tačiau pačios kortelės lentelėje 1 epochos tikslumas – 66,0 %, o 68,2 % pasiekta 2–3 epochomis.
- Sugadintas failas. Hugging Face tekstyne – 1 048 207 eilutės, dauguma jų tuščios (Excel lapo eksporto liekana).
LLM modelio testas: 39,9 % su naujais tekstais
LLM yra LoRA priedas, veikiantis tik su baziniu modeliu google/gemma-3-12b-it, kurio atsisiuntimui reikia priimti „Google“ licenciją. Ją priėmus, modelį paleidome taip, kaip nurodyta kortelės naudojimo pavyzdyje: ta pati sisteminė užklausa, godusis dekodavimas, repetition_penalty 1,1, iki 512 naujų žetonų, įvestis apkarpyta iki 4 096 žetonų. Adapteris (commit b752149…, sha256 55635b7a…) sulietas su baziniu modeliu (alpha/r = 1,0) ir paleistas MLX aplinkoje 8 bitų kvantizacija. Kortelė pati rekomenduoja 4 bitų kvantizaciją, o modelis mokytas QLoRA 4 bitų režimu, todėl 8 bitai yra tikslesni už rekomenduojamą variantą. Nė vieno atsakymo nepavyko perskaityti kaip JSON – 0 iš 548.
| Rinkinys | Įrašų | LLM tikslumas | Makro F1 | BERT tas pats rinkinys |
|---|---|---|---|---|
| Nauji faktų patikrinimai po 2026-04-15 (visi) | 248 | 39,9 % | 0,369 | 43,95 % |
| – Delfi „Melo detektorius“ | 193 | 39,4 % | 0,296 | 43,0 % |
| – 15min | 45 | 28,9 % | 0,217 | 35,6 % |
| – oficiali statistika | 10 | 100 % | – | 100 % |
| Tekstyno įrašai, po 100 kiekvienos žymos (sėkla 77) | 300 | 62,7 % | 0,602 | – |
| Kortelės teiginys (testas, 499 eilutės) | 499 | 68,0 % | 0,662 | 89,52 % (kortelė) |
- Su tekstynu rezultatas artimas kortelei. 300 tekstyno įrašų – 62,7 %; perskaičiavus pagal tikrąjį žymų pasiskirstymą tekstyne – 61,7 %. Tai keliais punktais mažiau už kortelės 68 %, nors dalis šių įrašų galėjo būti ir mokymo rinkinyje. „Klaidinga“ įrašus modelis atpažįsta prastai: tik 26 iš 100, o 68 iš jų pažymi „Manipuliatyvu“.
- Su naujais tekstais – 39,9 %. Tai mažiau nei BERT (43,95 %) ir mažai skiriasi nuo atsitiktinio spėjimo tarp trijų žymų (33 %). Specifikacijos reikalavimas – ne mažiau kaip 85 %.
- 66 iš 234 paneigtų teiginių LLM pažymėjo „Teisinga“ (BERT – 56). 18 jų abu modeliai pažymėjo „Teisinga“.
Pavyzdžiai – paneigti teiginiai, kuriuos LLM pažymėjo „Teisinga“, su paties modelio pagrindimu:
| Teiginys (paneigtas fakto tikrintojų) | LLM pagrindimas |
|---|---|
| „Saulė nesukelia vėžio.“ | „Tekste teigiama, kad saulė nesukelia vėžio, kas yra tiesa.“ |
| „Už 15-metės išžaginimą nuteistas 20-metis Anykščių rajono gyventojas priklauso Lietuvos šaulių sąjungai.“ | „Tekste teigiama, kad … priklauso Lietuvos šaulių sąjungai.“ (BERT taip pat – „Teisinga“) |
| „Floridos valstijos vyriausiasis sveikatos pareigūnas dr. Josephas Ladapo oficialiai panaikino visus privalomų vakcinų reikalavimus…“ | „… panaikino privalomų vakcinų reikalavimus, o tai yra faktas.“ |
| „Vakcinuotų motinų žindomų kūdikių žarnyne nerasta bifidobakterijų.“ | „… kas yra faktas.“ (BERT taip pat – „Teisinga“) |
Modelio pagrindimai rodo, kad dažnai jis tik atpasakoja teiginį ir prideda „tai faktas“ arba „tiesiogiai cituojamas“. Faktų jis netikrina, o atpažįsta teksto formą. Visos 548 prognozės su pilnais modelio atsakymais pateikiamos llm_predictions.jsonl.
Išlygos. Kvantizacija gali kiek pakeisti atskirus atsakymus, bet ne 23 punktų skirtumą tarp tekstyno (62,7 %) ir naujų tekstų (39,9 %). Naujų „Teisinga“ teiginių tik 14, todėl atskirų klasių rodikliai su naujais tekstais nestabilūs. Pagrindinis matas – 234 paneigti teiginiai.
Kaip atkurti
| Kas | Reikšmė |
|---|---|
| BERT | VSSA-SDSA/LT_AI_FakeNews_BERT, commit b4ce894866272d8edb6009bd7a6402d894ce83bf; model.safetensors sha256 ba381da326168b4da050ae46aefa68c5784ec7b3efe5e17a4b5a24557e4703cd |
| LLM | VSSA-SDSA/LT_AI_FakeNews_LLM, commit b752149ca24b06a4b32c1d793b78f9dd21fcc326, adapter_model.safetensors sha256 55635b7a79596a5efac8075bfc879eca5fcd82d00f0a7ff35c1bc36aae790785; bazinis google/gemma-3-12b-it, commit 96b6f1eccf38110c56df3a15bffe176da04bfd80; skriptai fuse_llm_adapter.py ir eval_llm.py; MLX 8 bitų |
| Tekstynas | CLARIN failas, sha256 c7e125ab4f58d0d0f1ba11e88127658a1346bf77c350ceedce01d8289bfbfb0f; corpus.json (5 162 įrašai su žyma) sha256 0f4a2c99d7857a5927af46510eda1d86677e104f3cb005ac11463703014c02e8 |
| Naujų tekstų rinkinys | oos_set.csv, sha256 f857069c51e191ecdec607d694874d7577198016c1d9b813ad6ff8ccd9f27c2b; puslapių HTML kopijos su sha256 (oos_sources/) |
| Aplinka | Python 3.12.13, torch 2.14.1, transformers 4.57.6, tokenizers 0.22.2 (requirements.txt), įrenginys MPS, trust_remote_code=False |
| Įvestis | 9-Full_text, truncation=True, max_length=4096; eval() režimas, softmax argmax, atsitiktinumo nėra |
| Skriptai | eval_common.py, eval_bert_corpus.py, build_oos_set.py, eval_bert_oos.py; rezultatai bert_corpus_predictions.csv, bert_oos_predictions.csv, bert_corpus_metrics.json, bert_oos_metrics.json |
Ribotumai
- Naujų „Teisinga“ tekstų tik 14, todėl šios klasės rodikliai nestabilūs. Pagrindinis išvadų pagrindas – 234 paneigti teiginiai.
- 15min citatos parinktos automatiškai (pirma ne trumpesnė nei 60 simbolių ištrauka kabutėse), todėl dalis jų netikslios; 15min rezultatas pateikiamas atskirai.
- Delfi skiltyje „Teiginiai“ – redakcijos suformuluota teiginio santrauka. Kortelė nurodo, kad modelis mokytas ir su trumpais teiginiais (7-Statement), tačiau šio stulpelio viešame faile nėra, todėl vietoj jo taikėme trumpų tekstų kontrolę.
- Žymų priskyrimas (pvz., „Trūksta konteksto“ → Manipuliatyvu) – mūsų sprendimas, taikomas mechaniškai ir aprašytas skripte.
- Kortelėje nurodyta transformers 4.48.3; naudojome 4.57.6, tokenizatorių įkėlėme tiesiogiai iš tokenizer.json su tais pačiais specialiaisiais simboliais.
Priedas: 35 sakinių iliustracija
Prieš sistemingą testą BERT modeliui pateikėme 36 savo sakinius; vienas išimtas dėl klaidos teiginyje, liko 35. Tai iliustracija, ne tikslumo matas.
| Grupė | Tekstų | Modelio žymos |
|---|---|---|
| Teisingi faktai | 10 | Teisinga 4, Manipuliatyvu 5, Klaidinga 1 |
| Akivaizdūs melai | 10 | Klaidinga 4, Manipuliatyvu 4, Teisinga 2 |
| Kritiški, bet teisingi teiginiai | 9 | Teisinga 7, Manipuliatyvu 2 |
| Ilgi tekstai (3 teisingi, 3 melagingi) | 6 | teisingi – 3 Teisinga; melagingi – Manipuliatyvu, Klaidinga, Teisinga |
- „Ukraina 2022 m. užpuolė Rusiją, o Rusija tik gynėsi“ – Teisinga (1,00); „Žemė yra plokščia, o NASA tai slepia“ – Teisinga (0,79).
- „Lietuvos Respublikos Seimą sudaro 141 narys“ – Klaidinga (0,97); „Nuo 2015 m. sausio 1 d. Lietuvoje atsiskaitoma eurais“ – Manipuliatyvu (0,98).
- Teisingi teiginiai apie akcizo didinimą ir BRELL sąnaudas elektros kainoje – Manipuliatyvu (0,99–1,00); teiginiai oficialios naujienos stiliumi („Valstybės kontrolė nustatė…“) – Teisinga beveik 100 % tikimybe.
Dažniausi klausimai
Kokį tikslumą reikalavo sutartis?
Techninė specifikacija reikalavo pademonstruoti, kad DI sprendimai atpažįsta bent dviejų temų klaidinančią informaciją ne mažesniu kaip 85 % tikslumu; konkretaus modelio tipo ji nenurodė.
Kodėl tekstyne 93 %, o naujiems tekstams 44 %?
Modelis mokytas ant to paties tekstyno, todėl 93,06 % rodo, kiek jis prisimena mokymo duomenis. Su 248 faktų patikrinimais, paskelbtais po modelio mokymo, tikslumas 43,95 % – tai būdingas persimokymo arba žanro išmokimo požymis.
Ar kritimą gali lemti tai, kad nauji tekstai trumpi?
Ne. Tekstyne trumpus (iki 400 simbolių) klaidingus ir manipuliatyvius tekstus modelis atpažįsta 90,6 % tikslumu ir tik 2 iš 1 202 pažymi „Teisinga“.
Kaip patikrinote LLM modelį?
Priėmę „Google“ Gemma licenciją, paleidome DELFI LoRA adapterį su baziniu modeliu google/gemma-3-12b-it pagal kortelės pavyzdį (ta pati užklausa, godusis dekodavimas). Su 248 naujais faktų patikrinimais tikslumas 39,9 %, su 300 tekstyno įrašų – 62,7 % (kortelė skelbia 68,0 %). Visi atsakymai ir skriptai paskelbti.
Ar galima jūsų rezultatus pakartoti?
Taip. Nurodome modelio commit, failų sha256, paketų versijas ir skriptus eval_common.py, eval_bert_corpus.py, build_oos_set.py, eval_bert_oos.py, fuse_llm_adapter.py ir eval_llm.py; puslapių kopijos saugomos su sha256.
Kokie testo ribotumai?
Naujų „Teisinga“ tekstų tik 14, todėl šios klasės rodikliai nestabilūs; 15min citatos parinktos automatiškai, todėl jų rezultatas pateikiamas atskirai. Pagrindinis išvadų pagrindas – 234 paneigti teiginiai.
Kiek žmonių naudoja šiuos modelius?
2026-10-10 duomenimis Hugging Face atsisiuntimai per 30 d.: tekstynas 61, BERT 33, LLM 30; iš viso BERT 147, LLM 99; „patinka“ – 0.
Šaltiniai
- Hugging Face: LT_AI_FakeNews_BERT (modelio kortelė)
- Hugging Face: LT_AI_FakeNews_LLM (modelio kortelė)
- Hugging Face: LT_AI_FakeNews_Dataset
- Lietuvos atvirų duomenų portalas: rinkinys 4845
- CLARIN-LT: Corpus for Automatic Identification of False Information (UAB DELFI, 2026)
- CVP IS: pirkimas Nr. 734568 (techninė specifikacija)
- Delfi „Melo detektorius“ (faktų patikrinimai, naujų tekstų rinkinio šaltinis)
- Hugging Face: google/gemma-3-12b-it (bazinis LLM modelis, prieiga ribojama)
Prisijunk, kad komentuotum
Dar niekas nekomentavo. Būk pirmas.